Tentez d’abord Chapter 13
Correction S1
library (tidyverse)<- read_csv ("data/ventes.csv" , show_col_types = FALSE ) |> distinct () |> filter (! is.na (region)) |> mutate (date = as.Date (date), mois = floor_date (date, "month" ))<- ventes |> group_by (mois) |> summarise (ca = sum (montant), .groups = "drop" )head (ca_mois)
#> # A tibble: 6 × 2
#>   mois          ca
#>   <date>     <dbl>
#> 1 2023-01-01 1550.
#> 2 2023-02-01 1682.
#> 3 2023-03-01 1675.
#> 4 2023-04-01 2333.
#> 5 2023-05-01 2041.
#> 6 2023-06-01 2254.
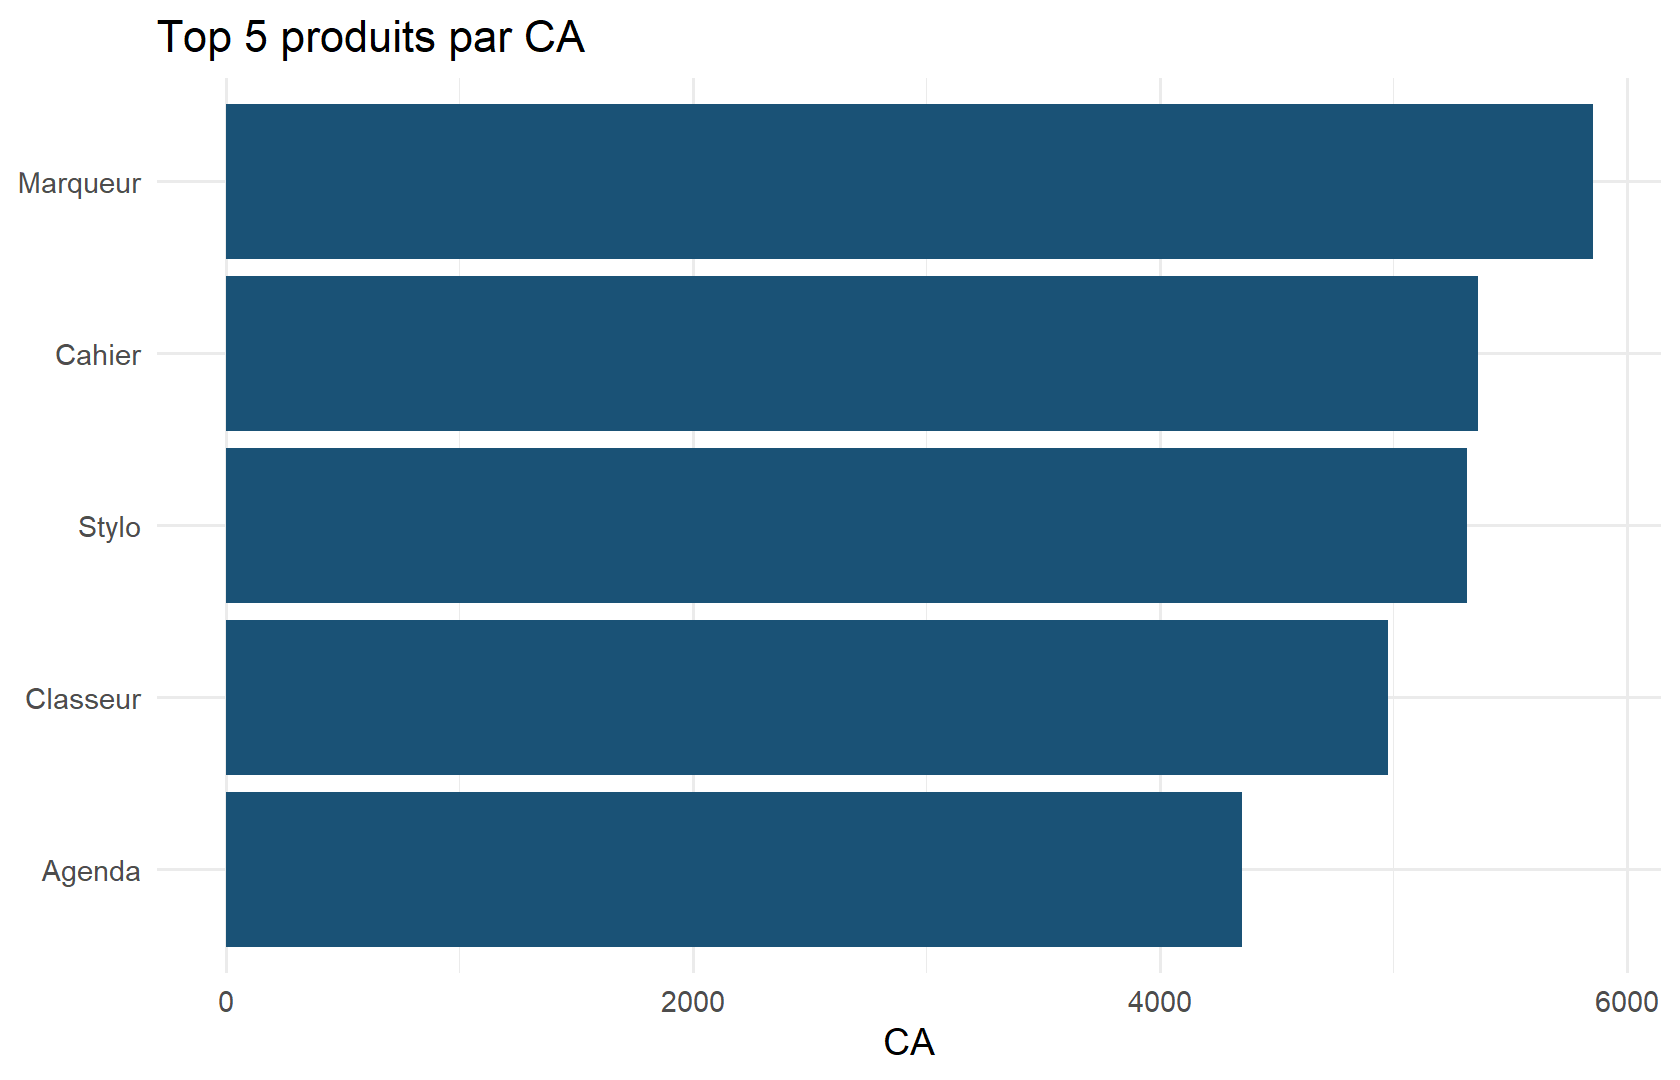
<- ventes |> group_by (produit) |> summarise (ca = sum (montant), .groups = "drop" ) |> slice_max (ca, n = 5 )ggplot (top5, aes (reorder (produit, ca), ca)) + geom_col (fill = "#1a5276" ) + coord_flip () + labs (title = "Top 5 produits par CA" , x = NULL , y = "CA" ) + theme_minimal ()cor (ventes$ quantite, ventes$ montant)# Phrase : association positive — davantage d'unités tend à augmenter le montant, sans impliquer un mécanisme causal unique.
Correction S2
<- read_csv ("data/demographie.csv" , show_col_types = FALSE )|> filter (age > 100 | revenu_mensuel > 20000 )
#> # A tibble: 2 × 6
#>      id   age sexe  ville revenu_mensuel niveau_etudes
#>   <dbl> <dbl> <chr> <chr>          <dbl> <chr>
#> 1     3   150 Femme Paris           1104 Bac
#> 2     7    54 Femme Paris          50000 Master
# Règle : exclure âge hors [18, 100] et revenus > 20000 comme erreurs de saisie # documentées pour ce jeu pédagogique synthétique. <- demo |> filter (age >= 18 , age <= 100 , revenu_mensuel <= 20000 )|> group_by (niveau_etudes) |> summarise (revenu_median = median (revenu_mensuel), n = n (), .groups = "drop" ) |> arrange (desc (revenu_median))
#> # A tibble: 5 × 3
#>   niveau_etudes revenu_median     n
#>   <chr>                 <dbl> <int>
#> 1 Doctorat              2334.     8
#> 2 Licence               2307     59
#> 3 Autre                 2168     19
#> 4 Master                2168.    24
#> 5 Bac                   2068.    38
Correction S3 (contenu attendu)
---
title: "Mini-rapport météo"
format: html
---

```{r}
library(tidyverse)
meteo <- read_csv("data/meteo.csv", show_col_types = FALSE) |>
  mutate(date = as.Date(date))
mean(meteo$temperature_c)
Limite : une seule ville simulée, pas de généralisation nationale.
## Correction S4

Dans `server`, ajouter par exemple :

```r
output$n_lignes <- renderText({
  paste("Lignes filtrées :", nrow(donnees()$data))
})
Et dans ui : textOutput("n_lignes") au-dessus de plotOutput("histo").
Réponses du quiz final
"integer"readr::read_csv (ou read.csv)Oui, les lignes où x est NA
geom_line (souvent avec date en x)La dispersion typique autour de la moyenne
Non (dépendance non linéaire possible)
quarto render --to pdfrenderPlotTraçabilité et possibilité de recommencer le nettoyage
Non